
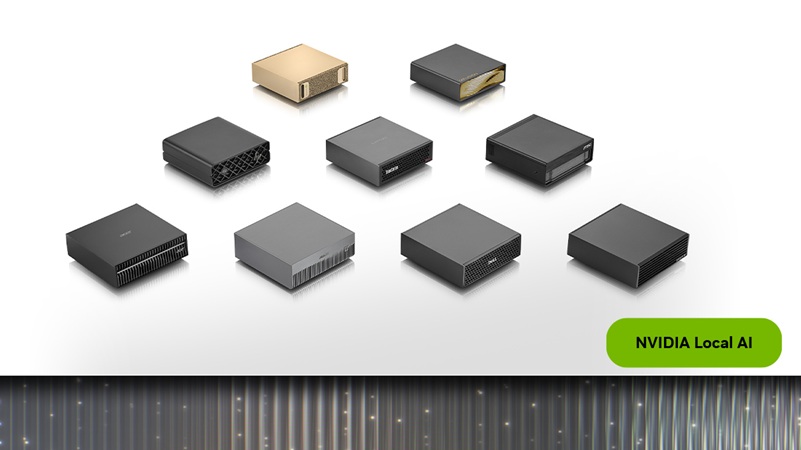
هوش مصنوعی محلی در حال تبدیل شدن به گزینهای جدیتر برای توسعهدهندگان است. همزمان با ورود عاملهای هوش مصنوعی به فرایندهای روزمره توسعه، مدلهای متنباز نیز کوچکتر و بهینهتر میشوند و امکان اجرای آنها روی طیف گستردهتری از دستگاهها فراهم میشود. در همین راستا، انویدیا نسخه جدیدی از ابررایانه شخصی DGX Spark را با 64 گیگابایت حافظه یکپارچه معرفی کرده است.
این مدل از ماه جاری میلادی توسط شرکتهایی مانند Acer، ASUS، Dell، Gigabyte، HP و MSI عرضه میشود و قرار است گزینهای در دسترستر برای توسعهدهندگان، پژوهشگران و علاقهمندان به هوش مصنوعی باشد. DGX Spark 64 GB از همان روز نخست به سیستمعامل DGX OS و مجموعه نرمافزاری هوش مصنوعی انویدیا مجهز است. این دستگاه میتواند اجرای مدلها و عاملهای هوش مصنوعی را بهصورت محلی انجام دهد و برای این کار نیازی به اتصال دائمی به سرویسهای ابری ندارد.
یک ابررایانه کوچک برای هوش مصنوعی محلی
DGX Spark مجموعهای از سختافزار و نرمافزارهای انویدیا را در قالب یک سیستم دسکتاپ جمعوجور ارائه میکند. این مجموعه شامل تراشه Grace Blackwell GB10، حافظه یکپارچه، کارت شبکه NVIDIA ConnectX-7 و پلتفرم نرمافزاری مبتنی بر CUDA است. انویدیا این دستگاه را برای طیف متنوعی از کارهای هوش مصنوعی، از جمله استنتاج مدلها، Fine-tuning، علم داده، توسعه عاملها و پردازشهای لبهای طراحی کرده است.
یکی از مزیتهای اجرای محلی این است که توسعهدهندگان میتوانند مدلها و دادههای اختصاصی خود را بدون ارسال آنها به زیرساخت ابری آزمایش کنند. به این ترتیب، DGX Spark میتواند برای پروژههایی که به حریم خصوصی دادهها یا دسترسی مستقل از سرویسهای ابری نیاز دارند، کاربرد داشته باشد. مدل جدید 64 گیگابایتی همچنان همان تراشه Grace Blackwell GB10، سیستمعامل DGX OS و مجموعه نرمافزاری مدل 128 گیگابایتی را در اختیار کاربران قرار میدهد، اما با ظرفیت حافظه کمتر و قیمت پایینتر عرضه میشود.به گفته انویدیا، این دستگاه امکان اجرای مدلهایی با حداکثر 100 میلیارد پارامتر را بهصورت محلی فراهم میکند.
اتصال دو DGX Spark برای اجرای مدلهای بزرگتر
در صورتی که 64 گیگابایت حافظه برای یک پروژه کافی نباشد، کاربران میتوانند دو دستگاه DGX Spark را به یکدیگر متصل کنند. هر DGX Spark به یک کارت شبکه ConnectX-7 مجهز است و دو سیستم را میتوان با یک کابل QSFP به یکدیگر متصل کرد. در این حالت، حافظه دو دستگاه با یکدیگر تجمیع میشود و مجموع ظرفیت به 128 گیگابایت میرسد. این ساختار امکان اجرای مدلهایی با حداکثر 200 میلیارد پارامتر را فراهم میکند. البته افزایش حافظه الزاماً به معنای دو برابر شدن عملکرد نیست.
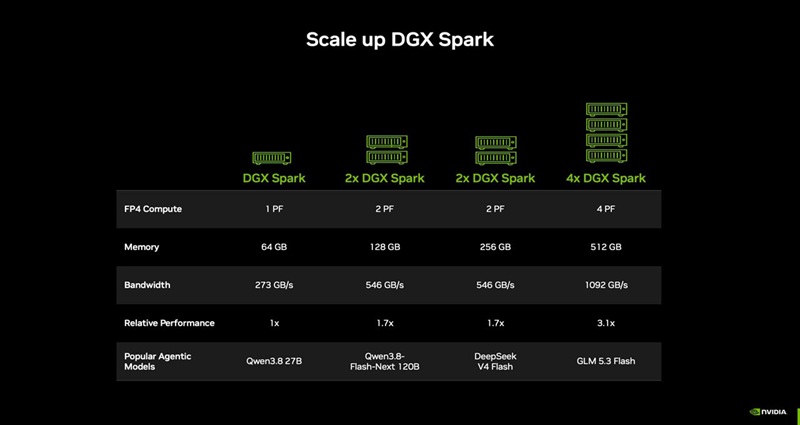
انویدیا میگوید در آزمایش این شرکت با مدل Qwen3.8 27B، اتصال دو سیستم 64 گیگابایتی تا 1.7 برابر عملکرد بیشتری نسبت به یک سیستم ارائه کرده است. برای سادهتر شدن این فرایند، انویدیا ابزار Sync Cluster Assistant را ارائه میکند. این ابزار دستگاههای متصل را شناسایی میکند، پیکربندی آنها را بررسی میکند و تنظیمات شبکه ConnectX-7 را انجام میدهد. به این ترتیب، کاربر برای تبدیل دو دستگاه به یک خوشه پردازشی، نیازی به انجام دستی بخش زیادی از تنظیمات زیرساختی ندارد. از آنجا که هر دو دستگاه از مجموعه نرمافزاری یکسان انویدیا استفاده میکنند، محیط نرمافزاری نیز هنگام افزایش مقیاس از یک سیستم به دو سیستم نیاز به بازپیکربندی ندارد.
اجرای عاملهای هوش مصنوعی روی DGX Spark
DGX Spark از ابتدا با هدف اجرای بارهای کاری هوش مصنوعی طراحی شده است. انویدیا میگوید ابزارهایی مانند NVIDIA Agent Toolkit، کتابخانههای CUDA-X AI و مدلهای متنباز Nemotron در این پلتفرم پشتیبانی میشوند. محیطهای اجرایی و چارچوبهایی مانند Ollama، vLLM و PyTorch with CUDA نیز در دسترس هستند. در نتیجه، توسعهدهندگان میتوانند پس از راهاندازی دستگاه، در مدت کوتاهی اجرای مدلهای محلی را آغاز کنند. Blender نیز از نخستین نرمافزارهای مورد استفاده سازندگان محتواست که پشتیبانی از این پلتفرم را در برنامه خود قرار داده است. انویدیا همچنین اعلام کرده است که یک نصبکننده آماده برای Blender بهزودی منتشر خواهد شد.
NVIDIA Sync اجرای مدلهای محلی را سادهتر میکند
انویدیا علاوه بر Cluster Assistant، ابزار دیگری با نام Sync Model Launcher نیز معرفی کرده که قرار است در پایان ماه عرضه شود. این ابزار برای سادهتر کردن اجرای مدلهای هوش مصنوعی روی یک یا چند دستگاه DGX Spark طراحی شده است. برای مثال، توسعهدهندگان میتوانند مدل Qwen3.8 27B را روی یک DGX Spark یا یک خوشه متشکل از دو دستگاه دانلود و اجرا کنند. NVIDIA Sync میتواند مدل را برای اجرای توزیعشده روی دستگاههای متصل پیکربندی کند و دسترسی به آن را از طریق لپتاپ کاربر فراهم کند. این لانچر همچنین OpenCode را برای استفاده از مدل تنظیم میکند تا توسعهدهنده بتواند فرایند کدنویسی را از طریق مرورگر آغاز کند.
سه کاربرد اصلی DGX Spark
NVIDIA برای DGX Spark چند سناریوی کاربردی را در نظر گرفته است.
- اجرای مداوم عاملهای هوش مصنوعی: توسعهدهندگان میتوانند یک عامل کدنویسی یا پژوهشی را بهصورت شبانهروزی روی دستگاه اجرا کنند. چنین عاملی میتواند برای بررسی کد، تحلیل اسناد یا انجام وظایف چندمرحلهای مورد استفاده قرار گیرد. اتصال چند دستگاه نیز امکان استفاده از مدلهای بزرگتر، پنجرههای زمینه طولانیتر یا اجرای همزمان چند عامل را فراهم میکند.
- استفاده از هوش مصنوعی در کنار رایانه شخصی: مدلهای تولید متن یا تصویر میتوانند روی DGX Spark اجرا شوند، در حالی که لپتاپ یا دسکتاپ کاربر وظایف دیگر را انجام میدهد. در این حالت، بخش مربوط به استنتاج مدل روی DGX Spark انجام میشود و منابع سیستم اصلی برای سایر کارها آزاد میماند.
- افزایش ظرفیت پردازشی در پروژههای بزرگتر: اگر یک پروژه از ظرفیت یک دستگاه فراتر برود، کاربر میتواند یک DGX Spark دیگر به سیستم اضافه کند. دو دستگاه +5 گیگابایتی در مجموع 128 گیگابایت حافظه در اختیار قرار میدهند و میتوانند برای مدلهای بزرگتر، پنجرههای زمینه طولانیتر یا درخواستهای همزمان بیشتر استفاده شوند.
قیمت و زمان عرضه DGX Spark 64 GB
انویدیا اعلام کرده است که نسخه 64 گیگابایتی DGX Spark از روز جمعه، 23 اکتبر، توسط Acer، ASUS، Dell، Gigabyte، HP و MSI عرضه خواهد شد. قیمت این دستگاه از 4999 دلار آغاز میشود. برای راهاندازی سیستم، کاربران میتوانند یکی از چارچوبهای استنتاج پشتیبانیشده مانند llama.cpp، Ollama، vLLM یا LM Studio را نصب و سپس مدل موردنظر خود را دانلود کنند. در صورت نیاز به افزایش ظرفیت، دو دستگاه DGX Spark را میتوان از طریق ConnectX-7 به یکدیگر متصل و NVIDIA Sync Cluster Assistant را اجرا کرد.
این ابزار تنظیمات شبکه و مسیریابی بارهای کاری را انجام میدهد. انویدیا همچنین مجموعهای از راهنماهای اجرای عاملهای هوش مصنوعی روی DGX Spark را برای ابزارهایی مانند NemoClaw، OpenClaw، Hermes Agent و OpenShell در build.nvidia.com منتشر کرده است.


هنوز نظری ثبت نشده
نظرات شما درباره «انویدیا نسخه 64 گیگابایتی DGX Spark...»اولین نفری باشید که نظر میدهید!
نظرات شما میتواند به بهبود محتوا و کمک به دیگران کمک کند.
ثبت اولین نظر