
پس از عملکرد ضعیف مدلهای Llama، متا طی سال گذشته میلیاردها دلار برای زیرساخت هوش مصنوعی و جذب استعدادهای این حوزه هزینه کرده است؛ بااینحال، مدلهای هوش مصنوعی این شرکت عمدتاً از محصولات پیشرفته OpenAI، آنتروپیک و گوگل عقبتر بودهاند. اکنون ممکن است این وضعیت تغییر کند؛ زیرا متا به خانوادهای از مدلها دست یافته است که توان رقابت در بالاترین سطح این حوزه را دارند.
متا امروز از مدلهای جدید خود با نامهای Muse Wonder و Muse Wonder Full رونمایی کرد. این خانواده مدل کمی بیش از یک ماه پس از انتشار Muse Spark 1.3 معرفی شده است؛ مدلی که بر بهبود تواناییهای برنامهنویسی و عملکرد عاملمحور تمرکز داشت. درحالیکه Muse Spark برای کوچک و کارآمد بودن طراحی شده بود، مدلهای Muse Wonder با بهرهگیری از پیشرفتهای حاصلشده در پیشآموزش و یادگیری تقویتی، در مرکز داده Prometheus متا با مقیاس توان گیگاواتی آموزش دیدهاند.
بر اساس مقایسههای معیار رسمی متا، Muse Wonder Full در سطحی رقابتی با GPT-6 Astra از OpenAI، Claude Opus 5.5 و Claude Fable 5.1 از Anthropic قرار دارد. این مدل در چندین آزمون معیار مربوط به وظایف عاملمحور و برنامهنویسی، حتی از محصولات OpenAI و Anthropic نیز بهتر عمل کرده است. برای مثال، Muse Wonder Full در آزمون SWE-Marathon که مدلهای هوش مصنوعی را در پروژههای مهندسی نرمافزار طولانیمدت ارزیابی میکند، امتیاز 57.5 درصد را به دست آورده است.
در مقایسه، امتیاز Claude Opus 5.5 برابر با 46.3 درصد و امتیاز GPT-6 Astra برابر با 42.5 درصد بوده است. در آزمون DeepSWE v1.1 نیز Muse Wonder Full به امتیاز 79٪ رسیده که از امتیاز 74.1 درصد برای GPT-6 Astra و 74.2 درصد برای Claude Opus 5.5 بیشتر است. این مدل در وظایف عاملمحور حرفهای نیز عملکرد خوبی داشته است. امتیاز آن در آزمون Harvey LAB-AA برای کارهای حقوقی به 13.1 رسیده، درحالیکه GPT-6 Astra امتیاز 8.6 و Claude Opus 5.5 امتیاز 4.2 را کسب کردهاند.
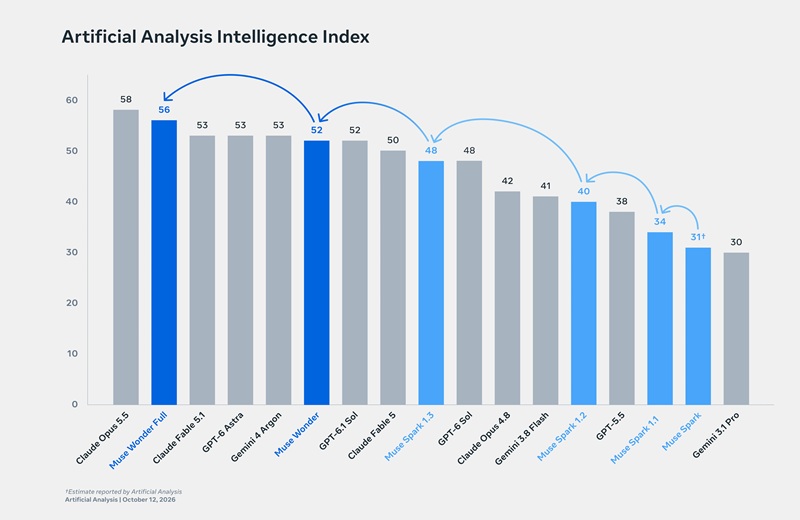
بااینحال، در شاخص هوش مصنوعی Artificial Analysis، امتیاز Muse Wonder Full برابر با 56 بوده است؛ یعنی اندکی پایینتر از امتیاز 58 برای Claude Opus 5.5، اما بالاتر از Claude Fable 5.1 و GPT-6 Astra که هر دو امتیاز 53 را کسب کردهاند. متا علاوه بر نتایج آزمونها، بر دو قابلیت این مدلهای سری Wonder تأکید کرده که بهطور ویژه برای عاملهای هوش مصنوعی شخصی طراحی شدهاند.
نخست، قابلیت Active Memory است که به مدل اجازه میدهد اطلاعات مهم را در طول گفتگوهای مختلف حفظ کند و در صورت نیاز، جزئیات مرتبط را بازیابی کند. دوم، قابلیت Active Focus است که به مدل کمک میکند در مواجهه با وظایف پیچیده پایداری بیشتری داشته باشد، هنگام شکست یک روش سراغ راهکارهای جایگزین برود و در صورت لزوم، درخواست توضیح یا تأیید کند. این قابلیتهای جدید میتوانند برای عامل هوش مصنوعی شخصی Muse متا مفید باشند.
هر دو مدل از پنجره زمینهای با ظرفیت 1 میلیون توکن پشتیبانی میکنند و قادر به پردازش متن، تصویر، صدا و ویدئو هستند؛ هرچند خروجی آنها به متن محدود میشود. مدل Muse Wonder هماکنون از طریق Meta Model API و ابزار برنامهنویسی Muse Code در دسترس است. در مقابل، مدل پرچمدار Muse Wonder Full فقط برای مشترکان Muse Code ارائه میشود. قیمت استفاده از API برای Muse Wonder بهازای هر 1 میلیون توکن ورودی 4 دلار و بهازای هر 1 میلیون توکن خروجی 20 دلار تعیین شده است.


هنوز نظری ثبت نشده
نظرات شما درباره «متا با Muse Wonder وارد رقابت...»اولین نفری باشید که نظر میدهید!
نظرات شما میتواند به بهبود محتوا و کمک به دیگران کمک کند.
ثبت اولین نظر