
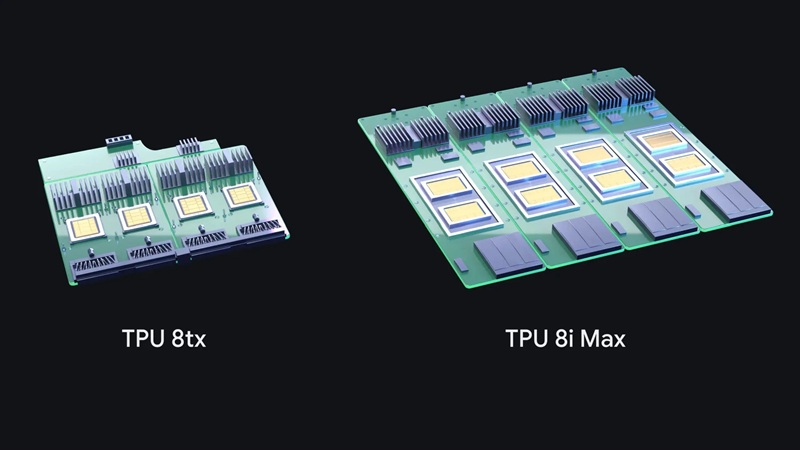
گوگل در ماه آوریل، خانواده تراشههای TPU نسل هشتم خود، یعنی TPU 8t و TPU 8i را معرفی کرد که بهترتیب برای آموزش مدلهای هوش مصنوعی در مقیاس بزرگ و استنتاج با تأخیر کم طراحی شدهاند. این شرکت مدعی شده بود که این نسل در مقایسه با نسل قبلی، تا 2.7 برابر عملکرد بهتر از نظر نسبت هزینه به کارایی در آموزش و 80 درصد عملکرد بهتر از نظر نسبت هزینه به کارایی در استنتاج ارائه میدهد. گوگل امروز از 2 تراشه TPU جدید با نامهای TPU 8tx و TPU 8i Max رونمایی کرد.
این تراشهها معماری کاملاً جدیدی ندارند؛ بلکه سیستمهای جدید از همان سیلیکون نسل هشتم TPU گوگل استفاده میکنند، اما با پیکربندیهای سختافزاری متفاوتی عرضه شدهاند که برای کاربردهای خاص بهینهسازی شدهاند. با معرفی محصولات امروز، گوگل اکنون 4 سیستم مبتنی بر TPU نسل هشتم در اختیار دارد. TPU 8tx جدید برای مشتریانی طراحی شده که به اجرای مدلهای هوش مصنوعی روی دادههای حساس نیاز دارند.
این سیستم که بر پایه همان سیلیکون TPU 8t ساخته شده و در کنار پردازندههای AMD EPYC نسل پنجم قرار گرفته است، از امنیت در سطح سختافزار استفاده میکند تا حتی هنگام پردازش دادهها و وزنهای مدل، از آنها محافظت کند. این قابلیت میتواند برای سازمانهای دولتی، مؤسسات مالی و سایر کسبوکارهای تحت نظارت قانونی مفید باشد؛ سازمانهایی که میخواهند عاملهای هوش مصنوعی را به کار بگیرند، بدون آنکه اطلاعات حساس خود را در معرض افشا قرار دهند.
گوگل همچنین شبکه Boardfly با تأخیر کم خود را در TPU 8tx به کار گرفته و مدعی است که این شبکه در مقایسه با TPU 8t، تأخیر را تا 2 برابر کاهش میدهد، آن هم تقریباً بدون هیچگونه افت عملکردی. این سیستم از استنتاج، تنظیم دقیق (Fine-tuning)، تقطیر مدل (Model Distillation) و یادگیری تقویتی پشتیبانی میکند و به شرکتها اجازه میدهد بدون انتقال دادههای خصوصی میان خوشههای مجزا، مدلهای خود را سفارشیسازی و اجرا کنند.
TPU 8i Max جدید بر بارهای کاری هوش مصنوعی متمرکز است که به پنجرههای متنی بسیار بزرگ نیاز دارند. گوگل با ترکیب 2 تراشه TPU 8i در قالب یک بسته واحد، توان پردازشی، حافظه SRAM روی تراشه و پهنای باند حافظه با پهنای باند بالا را در مقایسه با یک TPU 8i استاندارد 2 برابر کرده است. این محصول در همان فضای اشغالشده در رک، 2 برابر ظرفیت سیلیکونی ارائه میدهد و در نتیجه، تراکم محاسباتی را در مراکز داده افزایش میدهد.
انتظار میرود پهنای باند حافظه اضافی به عاملهای هوش مصنوعی کمک کند تا با مخازن کد بزرگ و وظایفی که به حافظه زیادی نیاز دارند کار کنند، بدون آنکه دائماً برای انتقال داده منتظر بمانند. در کنار معرفی 2 سیستم جدید TPU، گوگل در حال گسترش اکوسیستم نرمافزاری TPU خود نیز هست. از جمله اقدامات اخیر این شرکت میتوان به معرفی TorchTPU متنباز اشاره کرد که امکان اجرای بومی برنامههای PyTorch و مدلهای Hugging Face را روی TPUها، بدون نیاز به بازنویسی کد، فراهم میکند.
گوگل همچنین از مجموعه ابزارهای TPU Agent رونمایی کرده است که در حال حاضر در مرحله پیشنمایش قرار دارد. این مجموعه با ابزارهای برنامهنویسی مانند Claude Code، Cursor و Google Antigravity یکپارچه میشود تا بهینهسازی سختافزار را بهصورت خودکار انجام دهد. از دیگر بهروزرسانیها میتوان به سیستم مدیریت حافظه متنباز TPU Sync و عرضه عمومی Cloud Pathways و قابلیت Dynamic Slicing در Google Kubernetes Engine اشاره کرد.
نکته مهم این است که گوگل هنوز اطلاعات و معیارهای سنجش عملکرد اختصاصی کافی درباره TPU 8i Max، از جمله ارقام مربوط به مصرف انرژی و قیمتگذاری، منتشر نکرده است. بنابراین، در حال حاضر امکان مقایسه مستقیم این محصول با سیستمهای Rubin شرکت NVIDIA از نظر بهرهوری و هزینه وجود ندارد.


هنوز نظری ثبت نشده
نظرات شما درباره «گوگل از دو تراشه جدید TPU...»اولین نفری باشید که نظر میدهید!
نظرات شما میتواند به بهبود محتوا و کمک به دیگران کمک کند.
ثبت اولین نظر