
شرکت علی بابا از مدل هوش مصنوعی جدید Qwen4-Max رونمایی کرده که با معماری جدیدی از نوع Mixture of Experts (MoE)، قابلیت درک بومی تصاویر و پنجره متنی با ظرفیت 1 میلیون توکن طراحی شده است. این مدل برای انجام وظایف حرفهای، خلاقیت و پژوهش توسعه یافته و بهبودهایی در برنامهنویسی، استفاده از ابزارهای تخصصی و اجرای وظایف پیچیده و چندمرحلهای ارائه میدهد.
معماری جدید و قابلیتهای چندوجهی
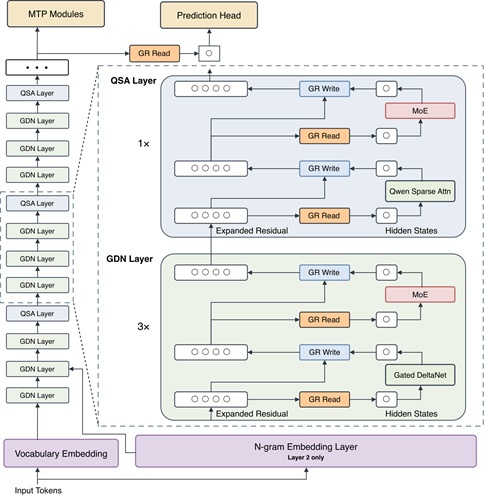
Qwen4-Max بر پایه معماری جدید MoE ساخته شده است. این معماری به مدل اجازه میدهد برای هر بخش از پردازش، تنها بخشی از پارامترهای خود را فعال کند و در نتیجه، منابع محاسباتی را بهشکل کارآمدتری به کار بگیرد. یکی از ویژگیهای مهم این مدل، پشتیبانی بومی از بینایی (Native Vision) است. Qwen4-Max میتواند علاوه بر متن، ورودیهای تصویری و ویدئویی را نیز پردازش کند. پنجره متنی 1 میلیون توکنی آن نیز امکان کار با حجم بسیار زیادی از اطلاعات را در یک نشست فراهم میکند.
این مدل برای کاربردهایی از جمله موارد زیر طراحی شده است:
- برنامهنویسی پیچیده و توسعه نرمافزار
- انجام وظایف اداری و افزایش بهرهوری در محیط کار
- طراحی رابط کاربری و توسعه فرانتاند
- اجرای وظایف پیچیده و چندمرحلهای با کمک عاملهای هوش مصنوعی
- مدلسازی سهبعدی و توسعه بازی
- کاربردهای صنعتی و برنامهریزی فرایندهای تولید
- تحلیلهای مالی، امور حقوقی و حوزه سلامت
- پژوهشهای علمی پیشرفته
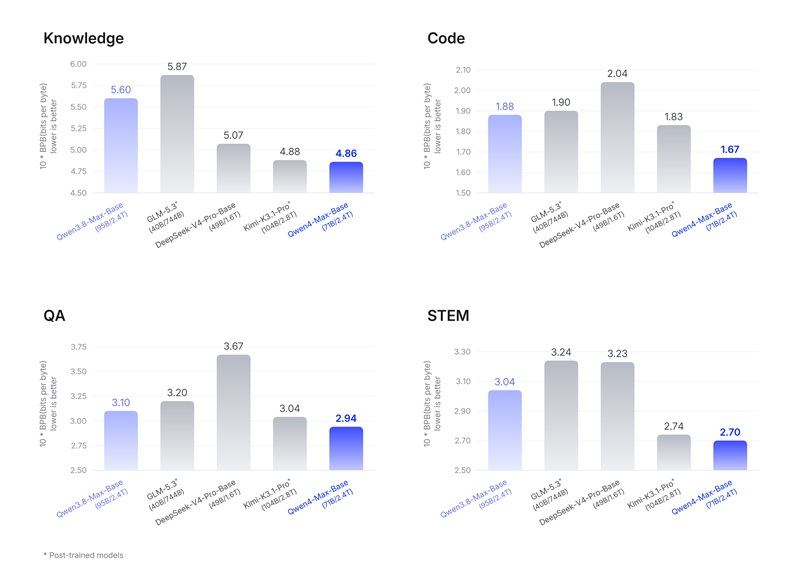
Qwen همچنین بر توانایی مدل در استفاده از ابزارهای حرفهای، اجرای وظایف طولانیمدت و تولید خروجیهای باکیفیتتر تأکید کرده است. به گفته Qwen، ارزیابیهای داخلی این شرکت نشان میدهد Qwen4-Max در مقایسه با Qwen3.8-Max میتواند با مصرف حداکثر حدود 50 درصد توکن کمتر، نتایج بهتری ارائه دهد. همچنین میانگین هزینه انجام هر وظیفه بیش از 60 درصد کاهش یافته است. این ارقام حاصل ارزیابیهای داخلی Qwen هستند و در اطلاعیه منتشرشده، جزئیات امتیازهای آزمونهای معیار یا نتایج ارزیابی مستقل ارائه نشده است.
قیمتگذاری و دسترسی به Qwen4-Max
API مدل Qwen4-Max اکنون از طریق پلتفرم QwenCloud در دسترس قرار گرفته است. قیمت استفاده از آن به شرح زیر است:
| نوع استفاده | هزینه بهازای هر 1 میلیون توکن |
|---|---|
| توکن ورودی | 1.5 دلار |
| توکن خروجی | 4.5 دلار |
| حافظه پنهان ضمنی (Implicit Caching) | 0.075 دلار |
به گفته Qwen، این قیمتها از نرخهای مربوط به Qwen3.8-Max پایینتر هستند. هزینه حافظه پنهان ضمنی نیز 70 درصد کاهش یافته است. کاربران و توسعهدهندگان میتوانند از طریق پلتفرمهای زیر به مدل دسترسی پیدا کنند:
- QwenCloud: برای استفاده از API و توسعه برنامههای مبتنی بر مدل
- Qwen Studio: برای تعامل مستقیم با مدل
- QwenWork: برای انجام وظایف و فعالیتهای حرفهای
- Qoder: برای کاربردهای مرتبط با برنامهنویسی و توسعه نرمافزار
Qwen اعلام کرده است که Qwen4-Max تنها نخستین عضو از نسل جدید مدلهای Qwen4 است. این شرکت قصد دارد در ادامه، مدلهای کوچکتر این خانواده را با وزنهای باز (Open Weights) منتشر کند. این مدلهای کوچکتر بر پایه فناوریهای نسل Qwen4 ساخته خواهند شد و با توجه به قابلیتها و کاربردهایی که مدلهای کمحجمتر در آنها عملکرد بهتری دارند، بهینهسازی میشوند. بااینحال، Qwen هنوز تاریخ انتشار یا اندازه دقیق این مدلها را اعلام نکرده است


هنوز نظری ثبت نشده
نظرات شما درباره «معرفی Qwen4-Max: مدل هوش مصنوعی جدید...»اولین نفری باشید که نظر میدهید!
نظرات شما میتواند به بهبود محتوا و کمک به دیگران کمک کند.
ثبت اولین نظر